データ分析基盤とNoSQL
データウェアハウス・データマイニング・Hadoop・NoSQL の各方式を用語の定義で見分けられるようになる。ストリーミング再生のバッファリング時間を、ビットとバイトの換算から正しく計算できるようになる。
このあたりは「用語の定義を4択で選ぶ」問題がほとんどで、意味の似た用語を並べてひっかけてきます。各用語の役割を一言で言えるようにしておけば、短時間で確実に取れる分野です。最後のバッファリング計算は、手順さえ覚えれば毎回同じ形で解けます。
このレッスンで稽古する(用語チェック・過去問)まず全体像:ためる・掘る・さばく
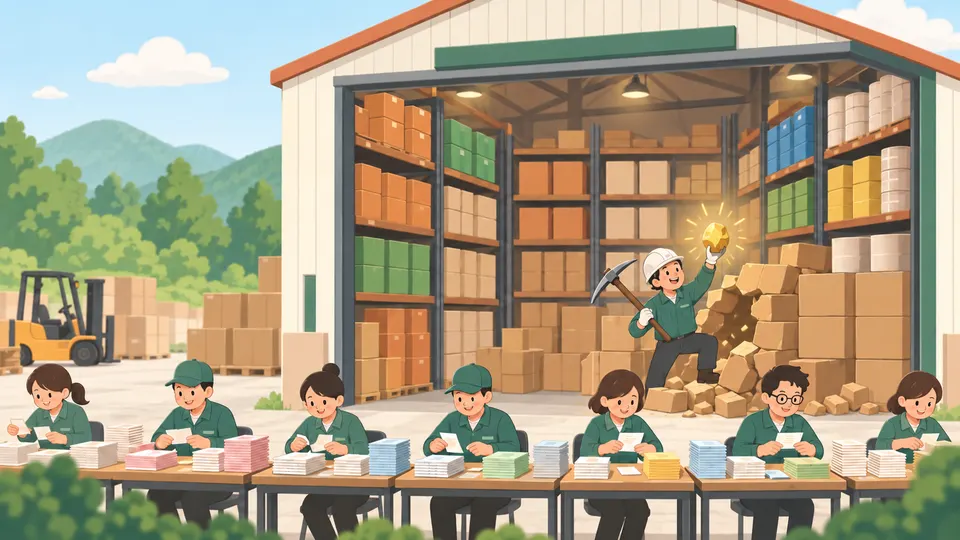
大量のデータを活かす流れは**「ためる → 掘る」の2段階で考えると整理しやすくなります。ためる場所がデータウェアハウス**、掘って傾向を見つける作業がデータマイニングです。量が多すぎて1台では処理しきれないときに、複数台に分けて処理する仕組みが Hadoop です。
たとえるなら、データウェアハウスは整理された巨大な倉庫です。データマイニングは、その倉庫の中身を調べて「この商品とこの商品はよく一緒に売れる」といった法則を見つける作業にあたります。倉庫そのものと、倉庫を調べる作業を取り違えないことが一番のポイントです。
データウェアハウス(DWH):意思決定のための倉庫
データウェアハウスとは、企業のさまざまな業務システムから集めた大量のデータを整理・統合して時系列で蓄積し、意思決定支援に使うデータベースです。売上・在庫・顧客などのデータを部門をまたいで集め、経営判断のために多角的に分析できる状態にしておきます。
日々の注文処理に使う業務用データベースは「いまの状態」を素早く更新することが目的です。これに対してデータウェアハウスは過去から積み上げた履歴を分析することが目的です。キーワードは**「統合」「時系列」「意思決定支援」**の3つです。
名前が似た用語との比較:
| 用語 | 一言でいうと | 見分けるキーワード |
|---|---|---|
| データウェアハウス | 分析用にデータを統合・蓄積する倉庫 | 大量・統合・時系列・意思決定支援 |
| データディクショナリ | データの定義(項目名・型・桁数など)を管理する辞書 | データの定義情報 |
| メタデータ | データについてのデータ(作成日・形式など) | データを説明する情報 |
| データアドミニストレーション | 組織のデータ資源を一元管理する活動 | 重複排除・一元管理という管理活動 |
| データマイニング | 蓄積データから傾向やパターンを見つける | 発見・統計的手法 |
データマイニング:データの山から法則を掘り出す
データマイニングとは、大量のデータから統計学的手法などを使って、まだ知られていない傾向・パターン・関係を見つけ出すことです。mining は「採掘」という意味で、鉱山から金を掘り出すイメージです。
試験では「新たな知識を見つけ出す」「有用な情報や関係を見つけ出す」という言い回しが出たら、データマイニングを選びます。選択肢には必ずデータウェアハウスが並びますが、こちらはためる仕組みであって、見つける作業ではありません。
ビッグデータ(従来の方法では扱いきれないほど量が多く、種類も多様なデータ)の活用例として出題されることもありますが、答え方は同じです。
Apache Hadoop:大量データを多数のサーバで手分けする
Apache Hadoop(ハドゥープ)は、大規模なデータを多数のサーバに分散して保存・処理するための OSS(オープンソースソフトウェア。ソースコードが公開され、利用・改変・再配布が認められているソフトウェア)です。柱は2つあります。
- HDFS:多数のサーバのディスクを1つの大きなファイルシステムとして扱う分散ファイルシステム
- MapReduce:処理を各サーバに分けて実行する Map と、その結果を集約する Reduce の2段階で、大量データを並列処理する方式
たとえば、1人では何日もかかる大量の伝票の集計を、100人に分けて同時に数えてもらい(Map)、最後に合計する(Reduce)イメージです。
同じ Apache 系で並べられる OSS との比較:
| OSS | 役割 | 見分けるキーワード |
|---|---|---|
| Hadoop | 分散ファイルシステム+分散バッチ処理 | 分散ファイルシステム・MapReduce |
| Spark | メモリ上で高速に処理する分散処理基盤 | インメモリ |
| Kafka | 大量のメッセージを受け渡す仕組み | メッセージング・配信 |
| Storm | 流れてくるデータを即時に処理する | ストリーム・リアルタイム |
「Hadoop の説明はどれか」という形では、アプリケーションサーバ・Web サーバ・RDBMS の説明と並べられます。**「大規模なデータを分散処理する」**とあればそれが Hadoop です。
NoSQL の4分類:キーバリュー・ドキュメント・列指向・グラフ
NoSQL とは、行と列の表で管理する関係データベース(RDB)以外のデータベースの総称です。大量のデータを多数のサーバで扱いやすくするために、データ構造を単純にしたり柔軟にしたりしています。試験では4つの型の説明文を並べて、1つを選ばせる形で出題されます。
| 方式 | データの持ち方 | 見分けるキーワード |
|---|---|---|
| キーバリュー型 | 一意に識別するキーと任意の値の組 | データと一意に識別できる値を組で保存 |
| ドキュメント型 | 1件を JSON や XML のドキュメントとして保存。構造は自由に変えられる | ドキュメント・JSON/XML・構造が自由 |
| 列指向型(ワイドカラム型) | キーごとに任意個数の列をもつ行 | キーに対して任意個数の列 |
| グラフ型 | ノード(点)とリレーションシップ(線)とプロパティ(属性)で関係を表す | ノード・リレーション・プロパティ |
| (参考)関係データベース | 行と列の2次元の表。集合論が基礎 | 表・行と列・集合論 |
キーバリュー型はコインロッカーのようなものです。鍵の番号(キー)さえ分かれば中身(値)をすぐ取り出せますが、中身が何であるかはロッカーは関知しません。グラフ型は SNS の友達関係のように、「誰と誰がつながっているか」を扱うのが得意です。
ストリーミング再生のバッファリング時間
ストリーミング再生とは、データをダウンロードしながら同時に再生することです。ダウンロードが再生より遅いと途中で止まるため、再生を始める前にある程度のデータをためておきます。これをバッファリングと呼びます。
考え方は1行で表せます。バッファリング時間 = 全体のダウンロード時間 − 再生時間です。再生が終わる瞬間にちょうどダウンロードも終われば途切れない、という条件から求めます。
計算で一番間違えやすいのは単位です。速度はビット/秒、データ量はバイトで与えられることが多いので、1バイト=8ビットでそろえてから割り算します。
試験での問われ方
- 定義を選ぶ問題:「大量データを整理・統合して蓄積し、意思決定支援に使うもの」→ データウェアハウス。「新たな傾向やパターンを見つけ出す」→ データマイニング。選択肢にはほぼ必ず、データディクショナリやメタデータが並びます。
- 説明文を選ぶ問題:用語は1つに固定され、選択肢には別の技術の説明が並びます(グループウェア、データ圧縮、データ管理など)。キーワードで消していきます。
- NoSQL の型:4つの型の説明を並べて、指定された1つを選ばせます。キーワード表で判定します。
- 計算問題:答えの選択肢に再生時間(100秒)やダウンロード時間(150秒)そのものが入っています。差を取ることを忘れないようにします。
音声データのバッファリング時間を求める
ア 50
イ 100
ウ 150
エ 250
解き方と答えを見る
- データ量の単位をビットにそろえる:2.4 Mバイト × 8 = 19.2 Mビット = 19,200 kビット
- 再生にかかる時間を求める:19,200 kビット ÷ 192 kビット/秒 = 100 秒
- ダウンロードにかかる時間を求める:19,200 kビット ÷ 128 kビット/秒 = 150 秒
- 途切れない条件を確認する:再生開始前のバッファリング時間を t 秒とすると、ダウンロード完了(150 秒後)が再生終了(t + 100 秒後)より遅くてはいけない。よって 150 ≦ t + 100
- t を求める:t ≧ 150 − 100 = 50 秒
答え:ア:50 秒(ダウンロード時間 150 秒 − 再生時間 100 秒)
要点(試験直前に読む)
- データウェアハウス=大量データを「統合・時系列」で蓄積し「意思決定支援」に使う倉庫。
- データマイニング=蓄積データから統計的手法で「新たな傾向・パターン」を見つけ出す作業。ためる(DWH)と掘る(マイニング)を区別する。
- Hadoop=「分散ファイルシステム+MapReduce」で大規模データを分散処理する OSS。
- NoSQL:キーと値の組→キーバリュー型、JSON/XML のドキュメント→ドキュメント型、キーごとに任意個数の列→列指向型、ノード・リレーション・プロパティ→グラフ型。行と列の表は関係データベース。
- バッファリング時間=ダウンロード時間 − 再生時間。バイト×8でビットに直してから割る。
ひっかけ
- 「整理・統合して蓄積」「意思決定支援」なのにデータマイニングを選ばせる→「ためる」はウェアハウス、「見つけ出す」はマイニング。
- データディクショナリ・メタデータを紛れ込ませる→これらは「データの定義・説明」であり、蓄積や分析の仕組みではない。
- Hadoop の問題に Spark・Kafka・Storm を並べる→「分散ファイルシステム」「MapReduce」があれば Hadoop。インメモリは Spark、メッセージングは Kafka、ストリームは Storm。
- NoSQL の型で「行と列の2次元の表」を混ぜる→それは関係データベース。グラフ型の「リレーション」と関係データベースの「表同士の関係」も混同しない。
- バッファリング計算で選択肢に 100 秒(再生時間)や 150 秒(ダウンロード時間)を置く→答えはその差。2.4 Mバイトをビットに直し忘れると数値がずれる。
用語(17)
複数の業務システムから集めた大量のデータを整理・統合して時系列で蓄積し、意思決定支援のための分析に使うデータベース。
⚠ データマイニングと混同しやすい。ウェアハウスは「ためる倉庫」、マイニングは「中身から法則を掘り出す作業」。
大量のデータから統計学的手法などで、まだ知られていない傾向・パターン・関係を見つけ出すこと。
⚠ データウェアハウスと混同しやすい。「見つけ出す」「新たな知識」とあればマイニング。
データの項目名・型・桁数・意味などの定義情報をまとめて管理するもの。
⚠ メタデータと近い。どちらも「データの定義・説明」であり、蓄積や分析の仕組みではない。
データそのものではなく、そのデータの形式・作成日・意味などを説明するデータ。
⚠ データディクショナリはメタデータを管理する辞書にあたる。データウェアハウスやマイニングの選択肢と区別する。
組織のデータを資源として捉え、重複をなくしたり一元管理したりする管理活動。
⚠ データウェアハウスは分析用のデータベースそのもの。こちらはデータを管理する「活動」。
量が膨大で種類も多様なため、従来の方法では扱いきれないデータの総称。
分散ファイルシステム(HDFS)と MapReduce により、大規模データを多数のサーバで分散して保存・処理する OSS。
⚠ Spark(インメモリ処理)、Kafka(メッセージング)、Storm(ストリーム処理)と区別する。「分散ファイルシステム+MapReduce」なら Hadoop。
処理を多数のサーバに分けて実行する Map と、その結果を集約する Reduce の2段階で、大量データを並列処理する方式。
多数のサーバのディスクを1つの大きなファイルシステムとして扱う、Hadoop の分散ファイルシステム。
ソースコードが公開され、利用・改変・再配布が認められているソフトウェア。
⚠ 「無償であること」は要件ではない。有償で配布される OSS もある。
行と列の表で管理する関係データベース以外のデータベースの総称で、大量のデータを分散して扱いやすい。
⚠ 「行と列の2次元の表・集合論」は関係データベースの説明なので、NoSQL の選択肢ではない。
保存したいデータ(値)と、それを一意に識別するキーを組にして保存する NoSQL の方式。
⚠ ドキュメント型は「JSON などのドキュメント」、列指向型は「キーごとに任意個数の列」。「キーと値の組」だけならキーバリュー型。
1件のデータを JSON や XML などのドキュメントとして保存し、ドキュメントごとに構造を自由に変えられる NoSQL の方式。
⚠ キーバリュー型と区別する。「ドキュメント」「データ構造が自由」がキーワード。
個々のキーに対して任意個数の列をもつ行データを管理する NoSQL の方式。
⚠ 関係データベースの「行と列の表」と混同しやすい。「キーごとに任意個数の列」がキーワード。
データとデータのつながりを、ノード(点)・リレーションシップ(線)・プロパティ(属性)で管理する NoSQL の方式。
⚠ 関係データベースの「表同士の関係性(リレーション)」と混同しやすい。「ノード」が出てきたらグラフ型。
再生や処理が途切れないように、あらかじめデータを一時的にためておくこと。
音声や動画を1秒再生するのに必要なデータ量(ビット/秒)。
⚠ 通信速度(1秒にダウンロードできる量)と区別する。符号化速度で割ると再生時間、通信速度で割るとダウンロード時間。
このレッスンの過去問
- データウェアハウスの定義平成22年度 春期 基本情報技術者試験 午前 問33
- データマイニングの定義平成29年度 春期 基本情報技術者試験 午前 問29
- Apache Hadoopの定義(分散ファイルシステムとMapReduce)平成30年度 春期 基本情報技術者試験 午前 問20
- キーバリューストアの特徴(NoSQL分類)平成31年度 春期 基本情報技術者試験 午前 問30
- グラフ型データベースの特徴基本情報技術者試験 科目A免除 修了試験 20260614 実施分 問18
- ストリーミング再生のバッファリング時間計算平成29年度 秋期 基本情報技術者試験 午前 問31